Đang dịch bài sang tiếng Việt…
Bài dài (2 phần) được dịch theo đợt, đợt này có thể mất tới nửa phút. Bản dịch được lưu lại, lần sau mở ngay.
Bài viết giới thiệu các Bộ Lý Luận Dựa Trên Năng Lượng, một phương pháp mới tuyên bố đạt tốc độ suy luận nhanh hơn tới 385 lần so với các phương pháp trước. Nó nhấn mạnh lợi ích về hiệu suất và tiềm năng ảnh hưởng đến việc triển khai và hiệu năng của các mô hình AI.
Đang dịch bài sang tiếng Việt…
Bài dài (2 phần) được dịch theo đợt, đợt này có thể mất tới nửa phút. Bản dịch được lưu lại, lần sau mở ngay.
1Duke University2UIUC3Harvard University
arXiv CodeTL;DR – Chúng tôi giới thiệu Energy-Based Reasoners (EBRs), các mô hình suy luận học một hàm năng lượng trên các trạng thái suy luận tiềm ẩn và biểu diễn các cập nhật vòng lặp như gradient descent trên hàm năng lượng này. Giá trị của nó đánh giá các dự đoán ứng cử mà không cần bộ xác thực bên ngoài, trong khi gradient của nó hướng dẫn việc tinh chỉnh và cung cấp tín hiệu tự nhiên để dừng. Với chỉ 1,8 triệu tham số, EBR đạt độ chính xác 99,9 % trên Sudoku-Extreme trong khi sử dụng 345× ít tính toán suy luận hơn mô hình tốt nhất kế tiếp. Trên N-Queens và Graph Coloring, EBR đạt độ bao phủ tiên tiến nhất đồng thời duy trì độ chính xác gần 100 % cho mỗi mẫu đơn.
Vòng lặp là một thiên kiến quy nạp mạnh mẽ cho suy luận. Bằng cách lặp đi lặp lại một khối hồi tiếp, các mô hình vòng lặp có thể mở rộng độ sâu hiệu quả và cho phép suy luận đa bước trong không gian tiềm ẩn. Tuy nhiên, các mô hình vòng lặp hiện có không được hướng dẫn bởi một thước đo tiến trình rõ ràng, khiến việc xác định thời điểm dừng vòng lặp và cách cải thiện trạng thái hiện tại trở nên khó khăn. Để giải quyết vấn đề này, chúng tôi giới thiệu Energy-Based Reasoners (EBRs), những mô hình học một hàm năng lượng trên các trạng thái suy luận tiềm ẩn và biểu diễn các cập nhật vòng lặp như gradient descent trên năng lượng này. Năng lượng đánh giá các trạng thái tiềm ẩn, trong khi gradient của nó hướng dẫn việc tinh chỉnh và cung cấp tín hiệu dừng. Để đào tạo EBR hiệu quả, chúng tôi còn giới thiệu phương pháp đào tạo dựa trên khám phá để tìm thêm các mode và định hình tốt hơn cảnh quan năng lượng trên một tập hợp rộng hơn các trạng thái. Trên bốn bộ benchmark suy luận thuật toán, EBR đạt hoặc vượt qua các mô hình suy luận hồi tiếp trước đây, đạt độ chính xác 99,9 % trên Sudoku-Extreme trong khi sử dụng 345× ít tính toán suy luận hơn mô hình tốt nhất kế tiếp và duy trì mức tính toán đào tạo tương đương. Trên tất cả các benchmark đa nghiệm, EBR đạt độ bao phủ tiên tiến nhất các nghiệm hợp lệ riêng biệt đồng thời duy trì độ chính xác gần 100 % cho mỗi mẫu đơn. Những kết quả này cho thấy các mô hình dựa trên năng lượng là một hướng tiếp cận đầy hứa hẹn cho hiệu năng suy luận mạnh mẽ.
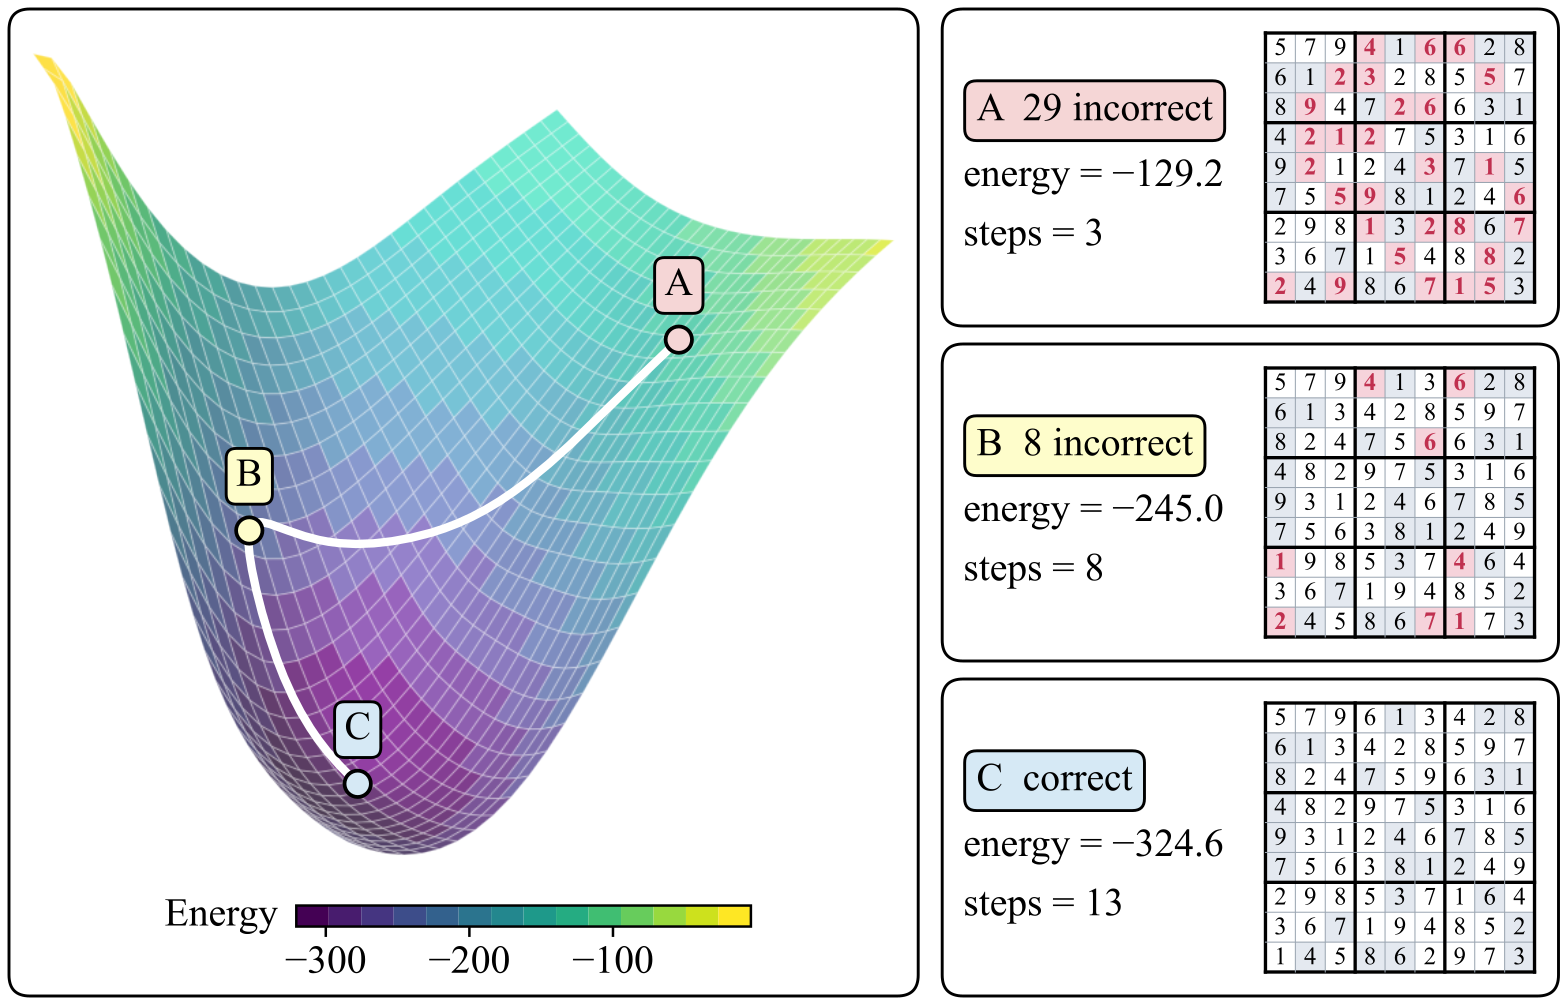
Các mô hình vòng lặp hiện có cập nhật trạng thái tiềm ẩn mà không có bất kỳ đánh giá rõ ràng nào. Một EBR học một hàm năng lượng để hướng dẫn việc tinh chỉnh, dừng và lựa chọn.
Score. Năng lượng đánh giá mức độ tương thích giữa trạng thái suy luận và bảng ban đầu. Giá trị thấp hơn nghĩa là tương thích tốt hơn.
Refine. Gradient biến điểm số thành hướng cải thiện.
Stop. Trạng thái trở nên ổn định khi gradient nhỏ, vì vậy gradient đóng vai trò là tiêu chí dừng.
Select. Giữa nhiều nghiệm ứng cử, chúng tôi chọn nghiệm có năng lượng thấp nhất.
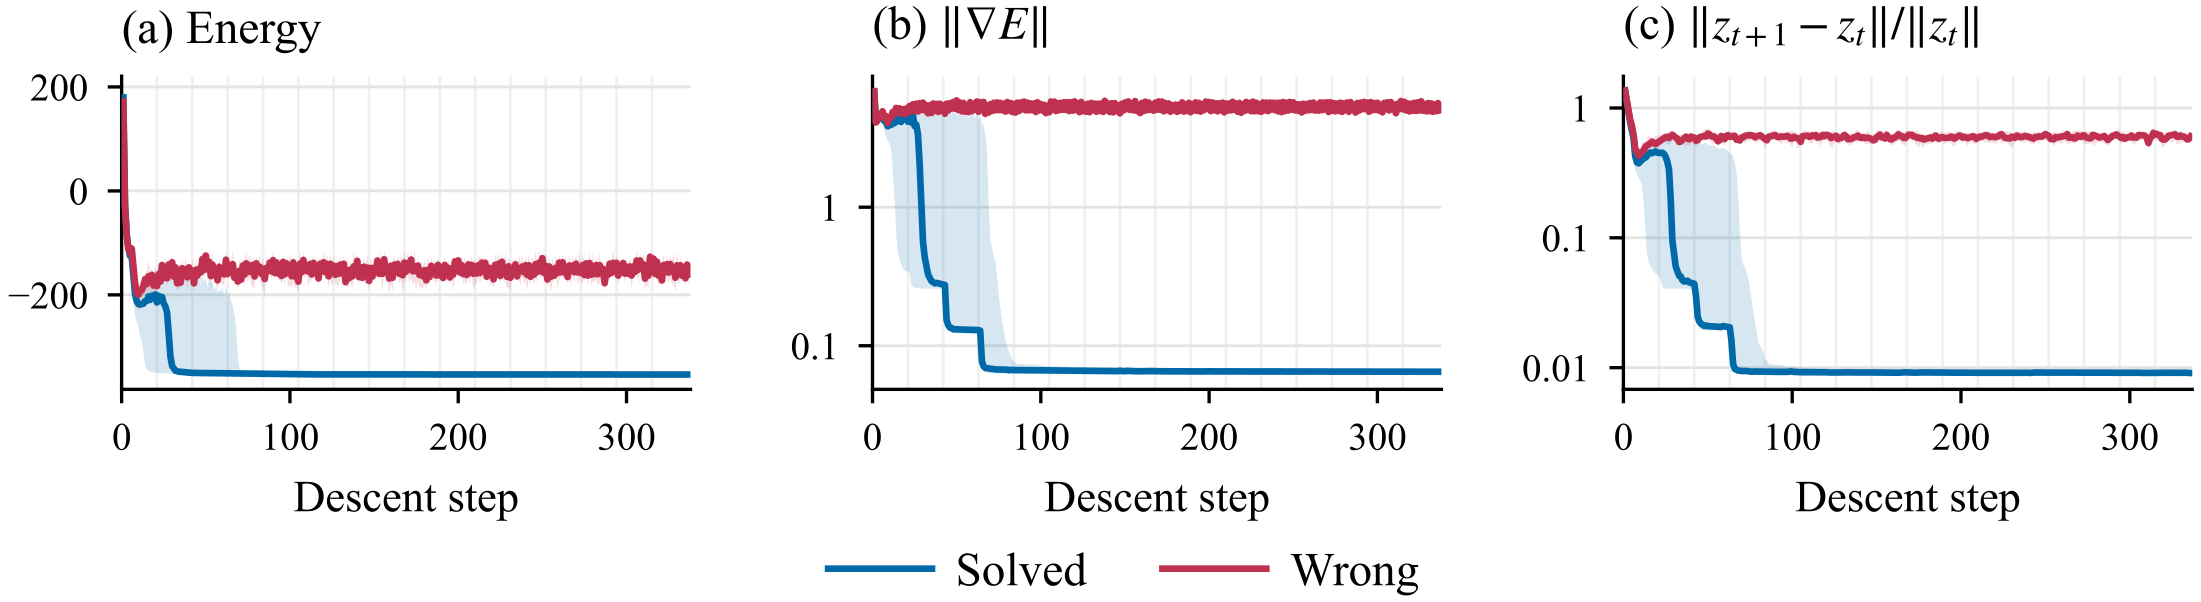
Các nghiệm đúng ổn định ở các trạng thái tĩnh năng lượng thấp. Năng lượng, chuẩn gradient và kích thước bước trong quá trình descent trên Sudoku-Extreme. Các đường đi đúng ổn định ở năng lượng thấp với gradient nhỏ, trong khi các đường sai vẫn tiếp tục di chuyển.
Thực hiện nhiều bước descent hơn sẽ tinh chỉnh mỗi câu trả lời hơn nữa, và chạy nhiều đường đi hơn sẽ cho năng lượng nhiều ứng cử viên để chọn nghiệm có năng lượng thấp nhất.
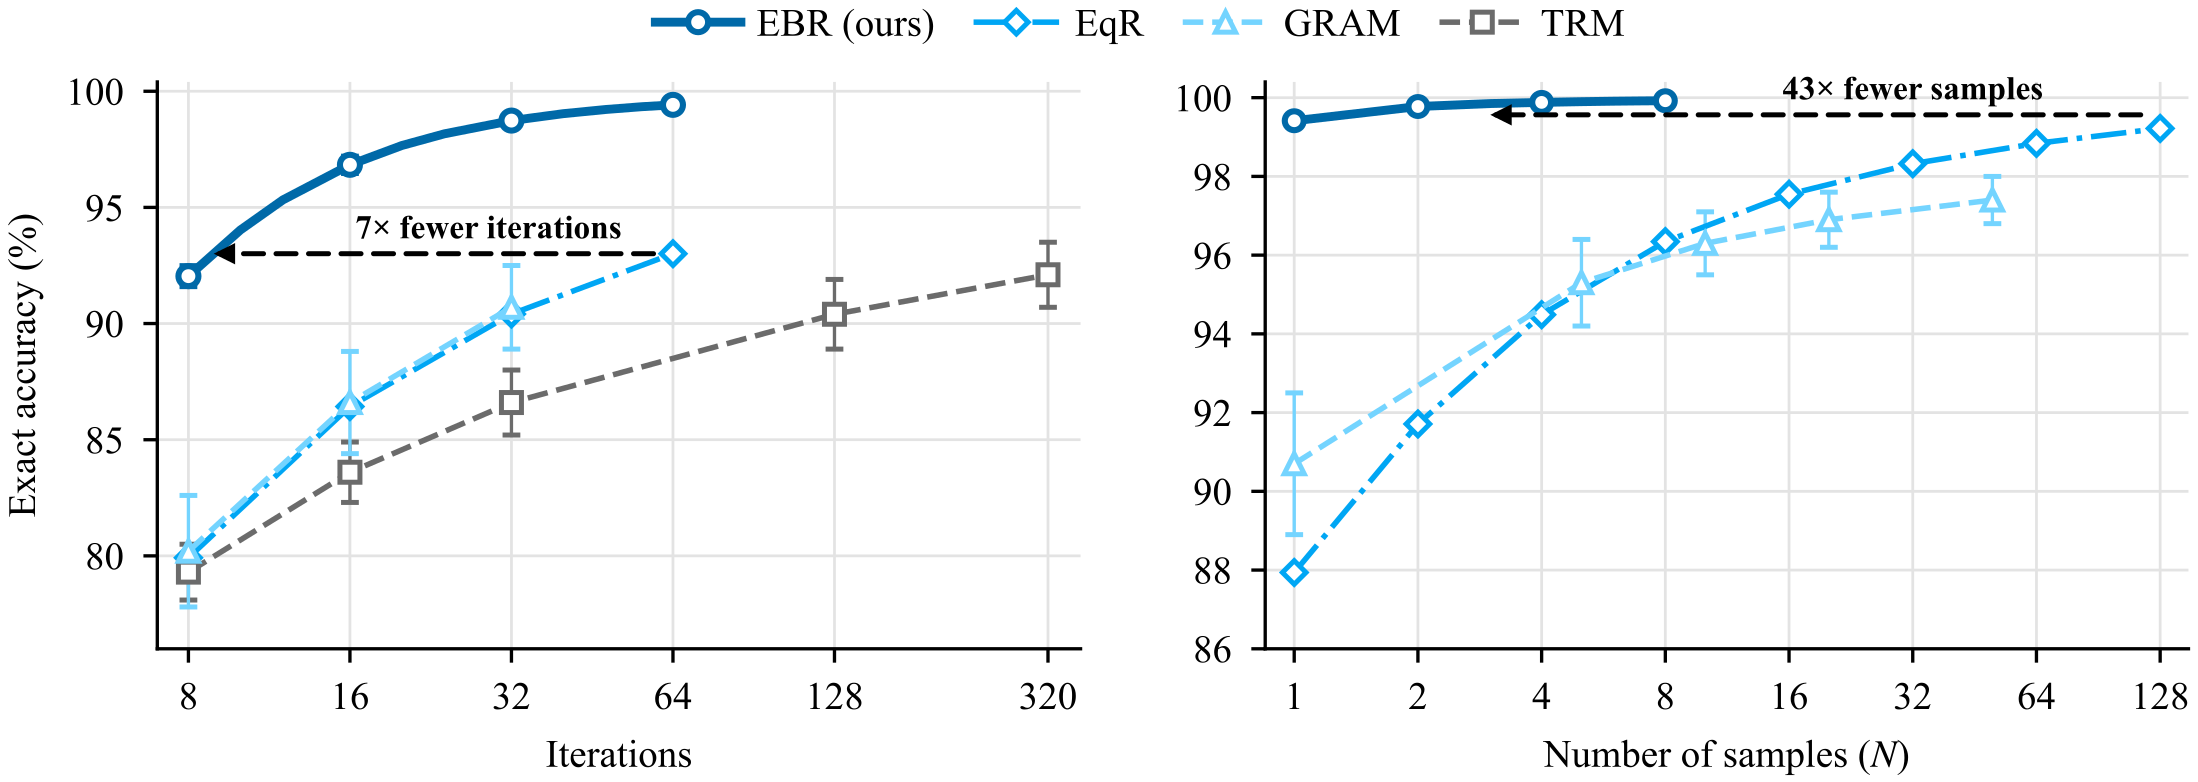
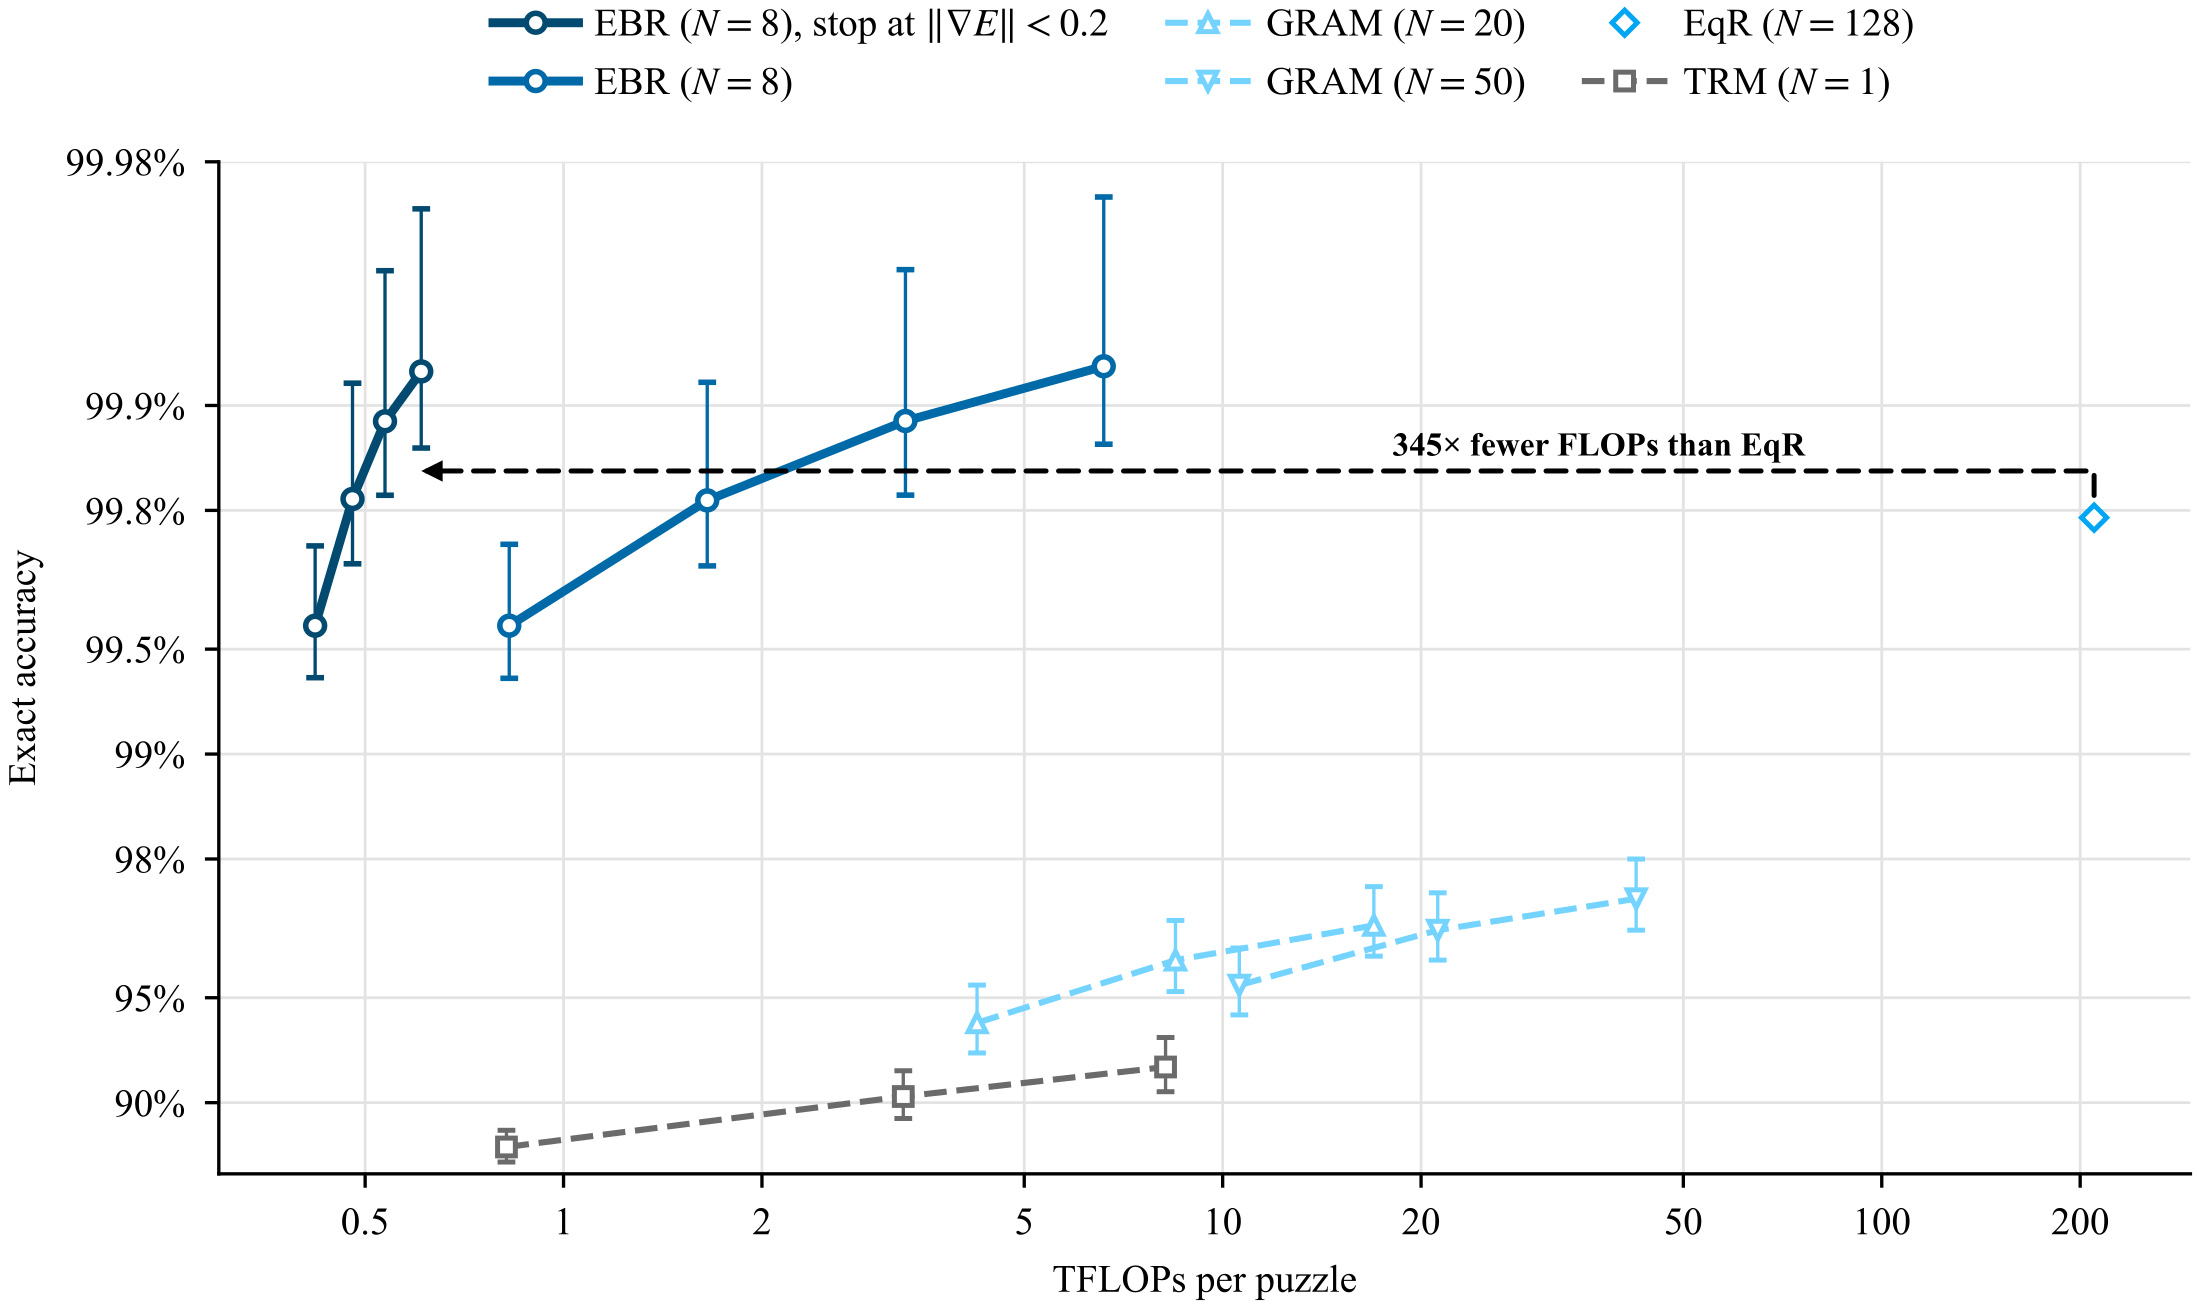
EBR đạt độ chính xác tốt nhất của EqR với 7× ít vòng lặp hơn (trái) và 43× ít mẫu hơn (phải).
GRAM và TRM từ bài báo của GRAM; EqR từ checkpoint đã phát hành. Trung bình ± Độ lệch chuẩn trên ba seed.
Mỗi đường đi dừng lại khi gradient năng lượng của nó giảm xuống dưới một ngưỡng, vì vậy các câu đố dễ sẽ hoàn thành trong vài bước và các câu đố khó sẽ tiếp tục.
| Phương pháp | # Tham số | Sudoku-Extreme ↑ | Maze-Hard ↑ |
|---|---|---|---|
| Mẫu đơn (%) | |||
| TRM | 5–7M | 87.4 | 85.3 |
| EqR | 5–7M | 93.0 | – |
| FPRM | 7M | 94.2 | 87.0 |
| GRAM | 10M | 86.6 | – |
| Luồng vòng | 5–7M | 97.9 | 86.7 |
| EBRChúng tôi | 1.8M | 99.4 | 87.4 |
| Nhiều mẫu (%), số mẫu N trong ngoặc | |||
| PTRM | 5–7M | 98.8(100) | 86.7(100) |
| EqR | 5–7M | 99.8(128) | – |
| GRAM | 10M | 96.1(20) | – |
| Luồng vòng | 5–7M | 99.3(5) | 86.9(5) |
| EBRChúng tôi | 1.8M | 99.9(5) | 88.3(5) |
EBR cho độ chính xác mẫu đơn tốt nhất trong số các mô hình suy luận. Chỉ trong 5 lượt, chúng đạt 99.9% và 88.3%, vượt qua các phương pháp dùng tới 128 lượt. Dừng mỗi quỹ đạo khi gradient năng lượng giảm xuống dưới ngưỡng giúp duy trì độ chính xác 99.9% với 10.9× ít FLOPs hơn so với EBR độ sâu cố định, cho phép chúng ta vượt qua EqR với 345× ít FLOPs hơn.
EBR hoạt động giống như gradient descent ngẫu nhiên và có thể nắm bắt nhiều giải pháp khác nhau. Độ bao phủ đo tỷ lệ các giải pháp hợp lệ riêng biệt của mỗi đầu vào mà 20 mẫu tìm được.
| Phương pháp | N-Queens | Màu đồ thị | ||
|---|---|---|---|---|
| 8×8 | 10×10 | 8-đỉnh | 10-đỉnh | |
| Mẫu đơn | Pass@1 (%) ↑ | Xung đột ↓ | ||
| TRM | 66.8 | 17.5 | 109.3 | 170.7 |
| GRAM | 99.5 | 89.7 | 8.3 | 31.3 |
| EBRChúng tôi | 100 | 99.5 | 0 | 0 |
| 20 mẫu | Cov@20 (%) ↑ | Cov@20 (%) ↑ | ||
| TRM | 22.6 | 2.0 | 22.3 | 6.8 |
| GRAM | 89.7 | 57.5 | 85.8 | 51.3 |
| EBRChúng tôi | 98.1 | 92.0 | 88.6 | 54.5 |
Pass@1 (%) và Xung đột (tổng số cạnh trên các đồ thị kiểm tra) dùng một mẫu. Cov@20 là tỷ lệ các giải pháp hợp lệ riêng biệt được tìm bởi 20 mẫu (%). Các baseline từ bài báo của GRAM.
@article{chen2026energy,
  title={Energy-Based Reasoners: Your Recurrent Reasoner Should Be an Energy-Based Model},
  author={Chen, William Xingxu and Gladstone, Alexi and Li, Zeyu Michael and Ji, Heng and Du, Yilun},
  journal={arXiv preprint arXiv:2611.08977},
  year={2026}
}
Bản dịch tự động bằng AI, thuật ngữ giữ nguyên tiếng Anh.