Đang dịch bài sang tiếng Việt…
Bài dài (5 phần) được dịch theo đợt, đợt này có thể mất tới nửa phút. Bản dịch được lưu lại, lần sau mở ngay.
Các nhà nghiên cứu Harvard nhận thấy việc giới thiệu các tác nhân mã AI đã chuyển nút thắt chính trong phát triển phần mềm từ việc viết mã sang việc kiểm tra mã. Nghiên cứu của họ nhấn mạnh nhu cầu về các thực tiễn và công cụ mới để đánh giá hiệu quả mã do AI tạo ra.
Đang dịch bài sang tiếng Việt…
Bài dài (5 phần) được dịch theo đợt, đợt này có thể mất tới nửa phút. Bản dịch được lưu lại, lần sau mở ngay.
Ghi chú của biên tập viên: Các kỹ sư tại các công ty áp dụng các đại lý mã AI đã thêm khoảng 30 % mã hơn, nhưng khối lượng công việc hoàn thành không tăng đáng kể và việc đưa mã qua quá trình đánh giá mất thời gian lâu hơn 49 %, theo một bài báo làm việc của các nghiên cứu sinh tiến sĩ Harvard Fiona Chen và James Stratton, dựa trên 718 công ty. Bài báo, một bài báo thị trường việc làm chưa có dấu hiệu được xét duyệt đồng nghiệp hoàn chỉnh, đo lường những gì xảy ra tại điểm kiểm tra con người khi tốc độ soạn thảo tăng lên. Quy trình từ chối kháng cáo của Harvey và đại lý che dấu của Cooley, vẫn đang phát triển cùng Google Cloud, đều giữ một luật sư tại một điểm kiểm tra tương tự, và không có thông báo nào đưa ra các số liệu về giai đoạn đánh giá đó.
Đối với các chuyên gia eDiscovery, bảo mật và tuân thủ, nghiên cứu đề xuất một cách tiếp cận đo lường cho những người mua AI pháp lý: cân nhắc sản phẩm công việc đã được phê duyệt, tỷ lệ sửa đổi và thời gian của người đánh giá cùng với đầu ra soạn thảo. Nó cũng cho thấy việc viết bằng AI có thể để lại siêu dữ liệu trong các hệ thống cộng tác mà các chương trình ghi lại và giữ dữ liệu pháp lý có thể cần truy cập. Hãy chú ý tới phiên bản sửa đổi của bài báo và bất kỳ nhà cung cấp pháp lý nào công bố các số liệu giai đoạn đánh giá, đồng thời nhớ rằng nghiên cứu này xem xét phần mềm, không phải công việc pháp lý.
Thông tin - 92%
Nhận thức - 90%
Liên quan - 88%
Khách quan - 90%
Thẩm quyền - 92%
Một đánh giá ngắn gọn dựa trên phần trăm về lợi ích định tính được biểu thị dưới dạng phần trăm phản hồi tích cực của bài viết gần đây từ ComplexDiscovery OÜ có tiêu đề “Các nhà nghiên cứu Harvard phát hiện các đại lý mã AI đã chuyển nút thắt sang giai đoạn đánh giá mã”.
Phân tích Tin tức – Mục Trí tuệ Nhân tạo
Nhân viên ComplexDiscovery OÜ
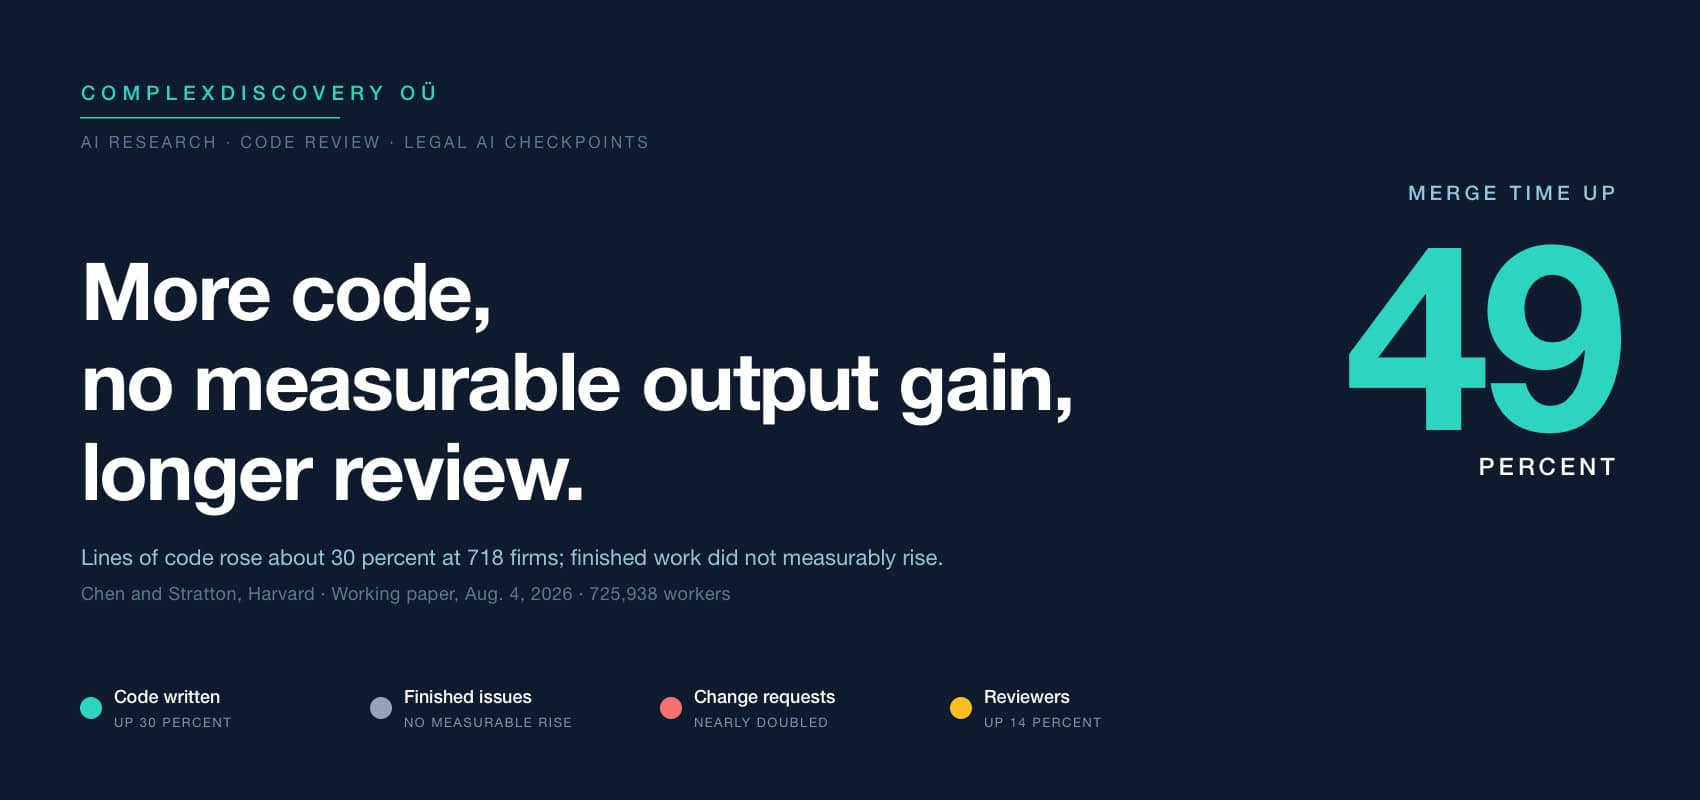
Các kỹ sư tại các công ty áp dụng các đại lý mã AI đã thêm khoảng 30 % mã hơn, nhưng khối lượng công việc hoàn thành không tăng đáng kể và việc đưa mã qua đánh giá mất thời gian lâu hơn 49 %, một bài báo làm việc của Harvard đã phát hiện.
Trong dữ liệu của nghiên cứu, lượng mã thêm vào không tạo ra sự tăng đáng nhận thấy trong công việc hoàn thành, và việc đánh giá mã trở thành nút thắt. Fiona Chen và James Stratton, cả hai đều là nghiên cứu sinh tiến sĩ tại Đại học Harvard, đã đo lường mô hình này trên 725.938 nhân viên tại 718 công ty. Hai thông báo AI pháp lý trong tháng này, quy trình từ chối kháng cáo của Harvey và một đại lý che dấu hồ sơ tòa án mà Cooley đang phát triển cùng Google Cloud, đặt một luật sư ở bước đánh giá tương tự, và không có thông báo nào đưa ra số liệu về nó.
Khối lượng mà mô hình này có thể chịu đựng phụ thuộc vào nguồn gốc của các con số. Chen và Stratton xây dựng nghiên cứu dựa trên dữ liệu từ Jellyfish, một công ty cung cấp nền tảng phân tích theo dõi hoạt động kỹ thuật, và kết hợp với hồ sơ tuyển dụng LinkedIn do Revelio Labs thu thập. Mẫu dữ liệu kéo dài từ tháng 1/2021 đến tháng 3/2026 và bao gồm các công ty khách hàng của Jellyfish đã đồng ý cho phép sử dụng dữ liệu cho nghiên cứu. Các bảng trong bài báo liệt kê 68,3 triệu vấn đề Jira, 200,9 triệu commit, 49,1 triệu pull request và 21,3 triệu sự kiện lịch, mặc dù chỉ có 213 trong số 718 công ty cung cấp dữ liệu lịch.
Thiết kế là so sánh chênh lệch theo thời gian (difference-in-differences) theo từng tháng, theo dõi cách các kết quả thay đổi tại các công ty áp dụng so với các công ty chưa áp dụng. Một so sánh như vậy chỉ tốt bằng mức độ khác nhau về thời điểm áp dụng, và ở đây các tác giả chỉ ra một quy trình mà các đội pháp lý và bảo mật sẽ nhận ra, vì họ nằm trong quy trình đó. Bài báo cho biết thời gian được hình thành chủ yếu bởi khi các công ty biết đến công cụ và thời gian mua sắm, bao gồm việc tìm nguồn, phê duyệt pháp lý và bảo mật, và các chương trình thí điểm. Một công ty của người được phỏng vấn phê duyệt công cụ trong khoảng một ngày; một công ty khác đưa thời gian phê duyệt trung bình là từ sáu đến mười hai tháng.
Các tác giả cho rằng những trì hoãn trong mua sắm này có khả năng không liên quan đến tốc độ tăng trưởng của công ty, điều mà họ cho rằng hỗ trợ việc so sánh giữa những người áp dụng sớm và muộn. Họ thừa nhận một sự mất cân bằng đã biết, là các công ty lớn hơn áp dụng sớm hơn, và họ kiểm soát kích thước công ty. Nếu còn sự khác biệt ẩn nào đó, các tác giả cho rằng nó có khả năng làm AI trông năng suất hơn thực tế, chứ không phải kém hơn. Một thiên lệch theo hướng này sẽ khiến kết quả sản lượng bằng phẳng, nếu có, trở nên "hào phóng" cho AI.
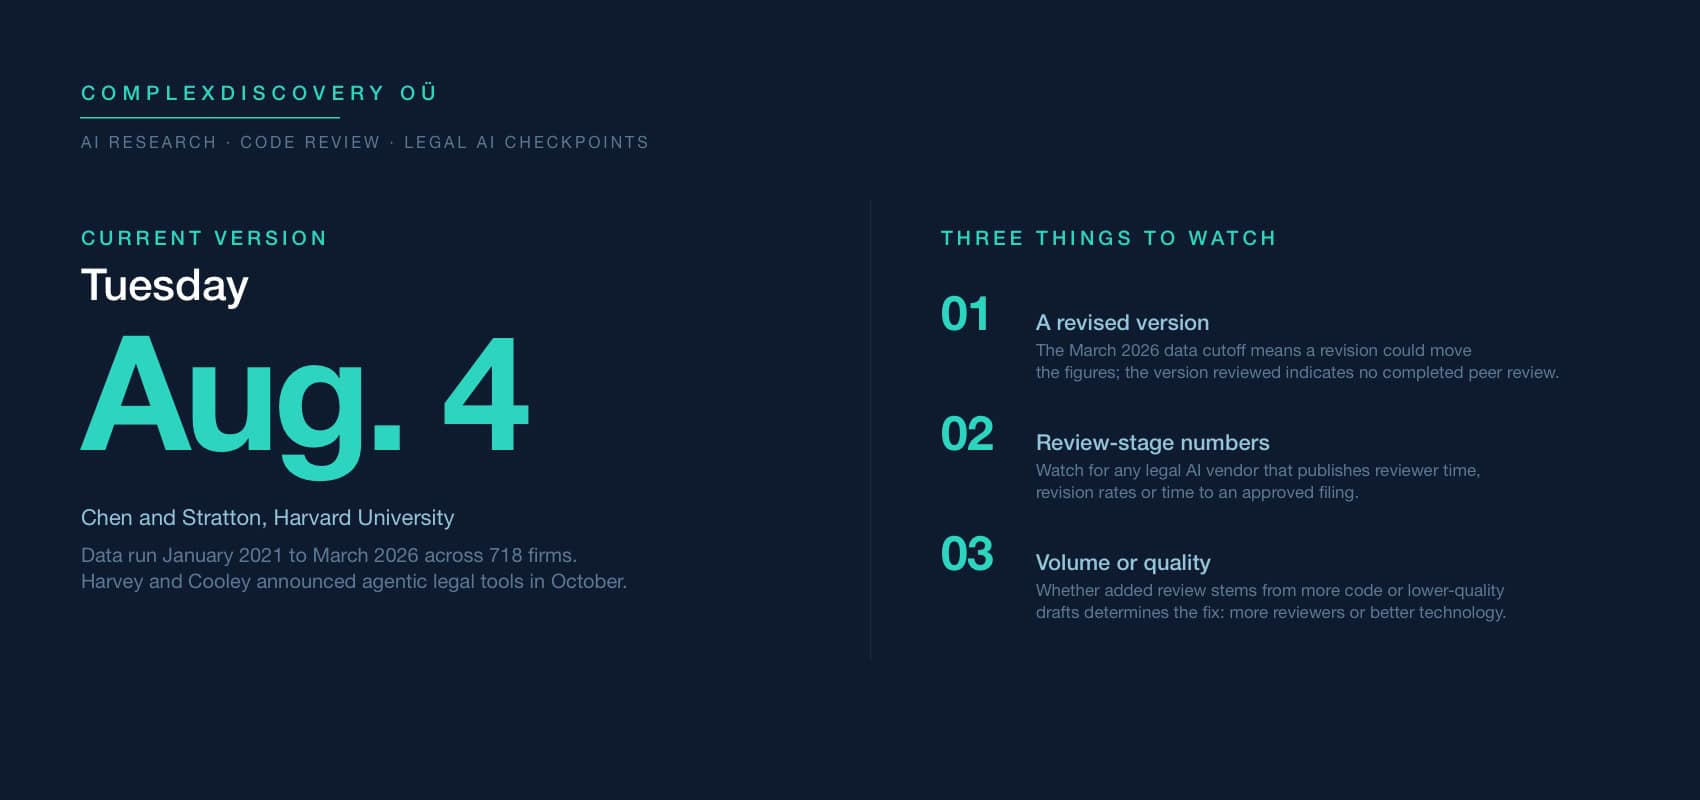
Phiên bản hiện tại của bài báo có ngày 4 tháng 8 năm 2026, và phiên bản đầu tiên có ngày 7 tháng 1. Chen đã phát hành nó như một bài báo thị trường việc làm, và không có gì trong phiên bản được xem xét cho bài viết này cho thấy đã được chấp nhận bởi tạp chí hay qua quy trình xét duyệt đồng nghiệp hoàn chỉnh. Trang web của cô liệt kê các liên kết truyền thông tới The Wall Street Journal và The Economist, và báo chí chuyên ngành pháp lý đã đưa tin trong tháng này, bao gồm một bài đăng vào ngày 12 tháng 10 trên eDiscovery Today của Doug Austin, truyền tải một báo cáo từ Ars Technica.
Với nguồn gốc này, kết quả về mã là đáng kể. Số dòng mã được thêm vào tăng 1.494 dòng mỗi công nhân-tháng so với mức cơ sở 5.017, tức khoảng 30 %. Các commit tăng 20 %, và các pull request, các gói mã được gửi để đánh giá, tăng 23 %. Các tác giả lưu ý rằng các ước tính này phản ánh hiệu ứng bổ sung của các đại lý tại các công ty đã có trợ lý mã AI, không phải hiệu ứng của AI từ đầu.
Đầu ra là nơi mà lợi nhuận dừng lại. Bài báo tính công việc đã hoàn thành là các vấn đề Jira đã giải quyết, và một vấn đề được coi là hoàn thành khi mã của nó được triển khai vào môi trường sản xuất. Các tác nhân đã di chuyển đo lường này giảm 0,12 vấn đề trên mỗi công nhân-tháng trên mức nền 3,67, với sai số chuẩn là 0,17. Kết quả này không thể phân biệt thống kê với zero, và khoảng tin cậy 95 % loại trừ việc tăng trên khoảng 12 % so với mức nền, xa hơn mức tăng 30 % về lượng mã được viết.
Các tác giả đã kiểm tra lối thoát rõ ràng. Nếu các kỹ sư chuyển sang các nhiệm vụ lớn hơn, số lượng vấn đề cố định sẽ làm giảm thực tế sản lượng. Vì vậy, các nhà nghiên cứu đã gán nhãn cho 0,5 % mẫu các vấn đề theo kích thước bằng GPT‑4o và mở rộng các nhãn này cho mọi vấn đề bằng một mô hình nhúng văn bản. Họ không thấy sự thay đổi nào trong kích thước trung bình của các vấn đề, và các pull request cũng không lớn hơn, điều mà các tác giả dùng để loại bỏ giải thích đơn giản nhất cho những gì đã xảy ra trong quá trình đánh giá.
Bài báo xác định thiếu hụt nằm ở việc xem xét mã. Thời gian từ khi gửi pull request đến khi hợp nhất tăng 3,45 ngày trên mức nền 7,03 ngày, tức tăng 49 %. Tỷ lệ pull request nhận yêu cầu thay đổi chính thức tăng khoảng 12 điểm phần trăm so với mức nền 13 %, gần gấp đôi, và số bình luận trên mỗi pull request tăng 35 %. Tỷ lệ nhân viên thực hiện bất kỳ việc xem xét mã nào tăng 14 % so với mức nền khoảng 29 %, trong khi tỷ lệ viết mã không có thay đổi đáng đo lường.
Các công cụ đánh giá AI không loại bỏ nút thắt. Đến tháng 3/2026, gần 80 % các công ty đã sử dụng một công cụ, nhưng AI chỉ tạo ra 23,3 % các bình luận đánh giá, và chỉ 10,8 % pull request nhận được ít nhất một bình luận AI. Các tác giả viết rằng nút thắt vẫn tồn tại sau khi các công ty áp dụng các công cụ này. Các cuộc phỏng vấn trong bài báo cho thấy điều đó diễn ra như thế nào trong một đội: một kỹ sư phần mềm trẻ mô tả một dự án mà chỉ có một kỹ sư cao cấp có thể phê duyệt thay đổi và chỉ có thể xem xét mã của người được phỏng vấn một lần mỗi tuần. “Sau một số sự cố ngừng hoạt động do các commit do AI tạo ra, cũng có những quy tắc mới yêu cầu sự phê duyệt của kỹ sư cao cấp cho mã do AI tạo, điều này tạo ra nhiều nút thắt đánh giá hơn,” kỹ sư nói, trong một trích dẫn mà các tác giả cho biết họ đã chỉnh sửa nhẹ để rõ ràng hơn.
Những câu chuyện này phù hợp với mô hình mà các tác giả dùng để giải thích số liệu của họ, mô hình có hai kênh. Kênh đầu tiên, việc soạn thảo nhanh hơn gửi nhiều mã hơn tới một nhóm người đánh giá cố định, một vấn đề mà việc chuyển lực lượng lao động sang đánh giá có thể giảm bớt phần lớn. Kênh thứ hai, sự tăng lên của các yêu cầu thay đổi và bình luận, mà việc soạn thảo nhanh hơn một mình không giải thích được, được mô hình đọc như dấu hiệu của các bản nháp chất lượng thấp hơn. Vấn đề này, các tác giả cho biết, sẽ đòi hỏi công nghệ tốt hơn. Bất kỳ ai mua một tác nhân nào cũng nên quan tâm kênh nào chiếm ưu thế, vì hai kênh yêu cầu chi tiêu khác nhau.
Không có sự giảm việc làm nào xuất hiện từ những lợi nhuận lập trình. Các ước lượng loại trừ mức giảm tổng thể việc làm lớn hơn 2,9 %. Một ước lượng ồn hơn loại trừ mức giảm việc làm kỹ thuật lớn hơn 13,8 %. Các tác giả cảnh báo rằng đây là các hiệu ứng ngắn hạn đo lường trong cân bằng một phần, có thể che giấu mất việc ở các công ty cạnh tranh, và ước lượng phụ cho việc làm kỹ thuật cho thấy xu hướng tăng trước đó khiến việc đọc nguyên nhân gây khó khăn.
Những kết quả phần mềm này xuất hiện khi các công cụ AI pháp lý áp dụng một thiết kế liên quan, và cả thông báo của Harvey và Cooley đều theo mô hình này: tự động hoá lần đầu, sau đó để luật sư kiểm tra tại điểm kiểm tra. Quy trình làm việc của Harvey, được đồng phát triển với LexisNexis và công bố ngày 7 tháng 10, là trường hợp soạn thảo. Harvey cho biết quy trình đa bước đọc đơn kiện, nghiên cứu và soạn thảo một đề nghị bác bỏ “thường mất 40 đến hơn 50 giờ làm việc” và công cụ của họ tạo ra nghiên cứu và bản nháp đầu tiên “trong vòng vài giờ.” Thông báo mô tả “các điểm kiểm tra của con người tại những thời điểm mà phán đoán của luật sư quan trọng nhất,” nhưng không nêu thời gian luật sư dành cho các điểm kiểm tra đó hoặc thời gian cần để có một đề nghị sẵn sàng nộp.
Thông báo ngày 8 tháng 10 của Cooley áp dụng cùng tư thế này cho một nhiệm vụ khác, vì tác nhân của họ đề xuất các phần cần xóa chứ không phải soạn thảo lập luận. Cooley cho biết tác nhân vẫn đang được phát triển và các luật sư thực hiện mọi quyết định xóa trước khi hồ sơ được nộp lên tòa, đặt điểm kiểm tra con người ở bước cuối cùng trước khi nộp. Như ComplexDiscovery báo cáo ngày 10 tháng 10, thông báo không đưa ra tỷ lệ lỗi.
Đối với một đề nghị nộp tại tòa án liên bang, điểm kiểm tra là một nghĩa vụ pháp lý chứ không phải một lựa chọn thiết kế. Theo Quy tắc Dân sự Liên bang 11(b), một luật sư trình bày một đề nghị phải chứng nhận một số điều về nó dựa trên kiến thức, thông tin và niềm tin tốt nhất của mình, “được hình thành sau một cuộc thẩm vấn hợp lý trong hoàn cảnh.” Các lập luận pháp lý của nó phải “được biện minh bởi luật hiện hành hoặc bởi một lập luận không vô lý để mở rộng, sửa đổi, hoặc đảo ngược luật hiện hành hoặc để thiết lập luật mới.” Các lập luận thực tế phải có bằng chứng hỗ trợ hoặc, nếu được xác định cụ thể, có khả năng có bằng chứng sau một cơ hội hợp lý để điều tra hoặc khám phá thêm. Một bản nháp đầu tiên có thể xuất hiện trong vài giờ, nhưng cuộc thẩm vấn đó vẫn thuộc về luật sư, và bằng chứng phần mềm làm dấy lên khả năng việc đánh giá có thể hấp thụ một phần tiết kiệm thời gian soạn thảo.
Phương pháp của bài báo mang lại một bài học thứ hai, dành cho các đội ngũ quản trị thông tin. Các nhà nghiên cứu đã xác định việc sử dụng agent một phần dựa trên các dấu vết trong hệ thống nội bộ của các công ty, bao gồm các tài khoản bot liên kết với công cụ AI và các chữ ký như dòng “Co‑authored‑by” trong tin nhắn commit và mô tả pull request. Tác giả AI có thể để lại dấu vết metadata riêng trong các hệ thống cộng tác. Dấu vết đó là một bản ghi mà lịch trình lưu trữ và lệnh giữ pháp lý có thể cần tiếp cận.
Điều này không có nghĩa là công việc pháp lý sẽ hành xử như phần mềm, và giới hạn của so sánh này rất quan trọng. Đánh giá tài liệu không phải là đánh giá mã, một bản sản xuất không phải là một pull request, và Chen cùng Stratton không nghiên cứu bất kỳ công việc pháp lý nào. Một bài báo làm việc riêng của Viện Nghiên cứu Kinh tế Quốc gia, được sửa đổi vào tháng 9 năm 2026, báo cáo sự suy giảm tương tự dựa trên dữ liệu của hơn 500.000 nhà phát triển GitHub. Các tác giả của nó, Mert Demirer, Leon Musolff và Liyuan Yang, đã phát hiện mức tăng tích lũy 240 % trong các commit từ các agent tự động, giảm xuống còn 30 % cho các bản phát hành thực tế. Bài báo này cũng có phần tiết lộ: Demirer và Musolff từng giữ vị trí nghiên cứu sau tiến sĩ tại Microsoft, công ty sở hữu GitHub, và hiện họ làm tư vấn nghiên cứu trả phí cho công ty. Hai nghiên cứu phần mềm chỉ ra một mô hình trong phần mềm, không phải là một phát hiện về các công ty luật.
Những người thực hành khám phá đã từng tranh luận về câu hỏi này, và bài viết của Austin đã rút ra so sánh đó. Ông viết rằng lĩnh vực khám phá đã chứng kiến một cuộc tranh luận tương tự về việc đánh giá AI sinh ra, với một số người thực hành cho rằng việc xác thực thủ công bù đắp lợi ích, trong khi những người khác, bao gồm cả ông, cho rằng việc lấy mẫu thống kê như trong mã hoá dự đoán là đủ. Đối với các agent mã hoá, tuy nhiên, ông viết rằng thời gian kiểm tra bổ sung có thể là cần thiết, vì mã đúng 90 % vẫn có thể không chạy được.
So sánh của ông gợi ý một cách chia hữu ích giữa hai loại đầu ra pháp lý. Công việc ở mức độ dân số như đánh giá mức độ liên quan lần đầu có thể được xác thực bằng việc lấy mẫu. Một hồ sơ đơn lẻ lại khác biệt, vì các trích dẫn, khẳng định thực tế và dữ liệu nhạy cảm thường cần được kiểm tra trực tiếp khi một trích dẫn giả mạo hoặc một số an sinh xã hội bị bỏ lỡ là nguyên nhân thất bại. Người mua có thể biến sự chia này thành một bài kiểm tra. Hỏi nhà cung cấp loại đầu ra nào mà agent của họ tạo ra, sau đó yêu cầu đo lường hạ nguồn thay vì đo lường việc soạn thảo: thời gian từ tải lên đến sản phẩm công việc được chấp nhận, tỷ lệ bản nháp mà luật sư kiểm tra trả lại và thời gian kiểm tra cho mỗi vụ việc. Hãy dự trù khả năng kiểm tra trước khi mở rộng khối lượng soạn thảo, và ghi lại những gì người kiểm tra thay đổi, vì bản ghi này cho thấy nút thắt là do khối lượng hay do chất lượng.
Những câu hỏi này cũng áp dụng cho nguồn dữ liệu của chính bài báo. Đối tác dữ liệu có lợi ích thương mại trong chủ đề này, và mối quan hệ sâu hơn một giấy phép dữ liệu. Jellyfish tự mô tả mình là một “Nền tảng Tác động AI,” và các tác giả đã đăng trên blog của họ: một bài viết ngày 25 tháng 9 năm 2025 của Chen và Stratton mô tả nó là “một phần của công việc đang diễn ra với Jellyfish.” Bài báo cảm ơn đội ngũ Jellyfish “vì sự hợp tác” và cho biết Jellyfish đã xem xét bản thảo chỉ để kiểm tra tiết lộ sở hữu trí tuệ, không phải nội dung khoa học, và các kết luận là của các tác giả. Những người tài trợ là Quỹ Stripe Economics of AI Fellowship, một chương trình của Trường Kennedy Harvard về phân phối của cải và Chương trình Schmidt Sciences AI at Work.
Jellyfish cũng đã quảng bá một phiên bản trước của công trình. Một bài đăng ngày 28 tháng 1 trên blog của họ bởi Nicholas Arcolano gọi nó là “một phiên bản sơ khởi của một bài báo mới từ các cộng sự của chúng tôi tại Harvard Economics, Fiona Chen và James Stratton,” dựa trên 100.000 kỹ sư phần mềm ở 500 công ty. Bài đăng đó, và một thông cáo báo chí của Jellyfish ngày 17 tháng 3 sau đó, báo cáo rằng AI đang làm cho việc mã hoá nhanh hơn và “chất lượng mã không có dấu hiệu suy giảm.” Phiên bản tháng 8, dựa trên mẫu lớn hơn chạy đến tháng 3 năm 2026, đọc sự gần gấp đôi các yêu cầu thay đổi qua mô hình như một dấu hiệu có thể của chất lượng bản nháp thấp hơn. Hai mô tả dựa trên các phiên bản và mẫu khác nhau, vì vậy chúng không nhất thiết phải mâu thuẫn, nhưng một độc giả dựa vào tóm tắt của Jellyfish sẽ bỏ lỡ câu hỏi về chất lượng mà bài báo hiện tại đưa ra.
Bài báo cũng chứa một số không nhất quán nội bộ nhỏ không ảnh hưởng đến ước tính agent chính. Phần giới thiệu làm tròn mẫu khoảng 700 công ty và 700.000 nhân viên, và phần chính mô tả 17 cuộc phỏng vấn trong khi phụ lục lại ghi 21. Các giới hạn khác là cấu trúc hơn là lỗi đánh máy: dữ liệu nền tảng là sở hữu riêng, và việc sử dụng công cụ AI qua các giấy phép cá nhân không được ghi lại.
Không có lời cảnh báo nào làm mất đi kết quả trung tâm, mặc dù việc cắt dữ liệu vào tháng 3 năm 2026 có thể dẫn đến sửa đổi các con số. Điều mà bài báo cung cấp là một tiêu chuẩn mà hai thông báo pháp lý được thảo luận ở đây không đáp ứng: tác giả được nêu tên, phương pháp được tiết lộ, khoảng tin cậy và một điểm kiểm tra đo lường. Nếu một agent cắt giảm 40 giờ nghiên cứu và soạn thảo xuống còn vài giờ, thì bao nhiêu trong số những giờ đó lại xuất hiện trên bàn làm việc của luật sư ký bản kiến nghị?
Nguồn tin tức
Hỗ trợ bởi Công nghệ GAI và Mô hình Ngôn ngữ Lớn
Đọc thêm
Nguồn: ComplexDiscovery OÜ
Sứ mệnh của ComplexDiscovery là giúp làm rõ các quyết định phức tạp bằng cách cung cấp các báo cáo, nghiên cứu và bình luận độc lập, dựa trên dữ liệu, giúp rủi ro kỹ thuật số, công nghệ pháp lý và thay đổi quy định trở nên dễ hiểu hơn đối với các nhà thực hành, nhà hoạch định chính sách và lãnh đạo doanh nghiệp.
Có yêu cầu?
Nếu bạn có thông tin hoặc yêu cầu cung cấp nào mà muốn hỏi chúng tôi, xin vui lòng cho chúng tôi biết, và chúng tôi sẽ ưu tiên phản hồi cho bạn.
ComplexDiscovery OÜ là một ấn phẩm kỹ thuật số độc lập và tổ chức nghiên cứu có trụ sở tại Tallinn, Estonia. ComplexDiscovery bao phủ các lĩnh vực an ninh mạng, bảo mật dữ liệu, tuân thủ quy định và eDiscovery, với các báo cáo kết nối các phát triển công nghệ pháp lý và kinh doanh—bao gồm xu hướng khởi nghiệp tăng trưởng nhanh—với doanh nghiệp quốc tế, chính sách và động lực an ninh toàn cầu. Tập trung vào các vấn đề công nghệ và rủi ro do quy định xuyên biên giới và sự phức tạp địa chính trị tạo ra, ComplexDiscovery cung cấp nội dung biên tập, phân tích gốc và các bản tóm tắt được chọn lọc cho khán giả toàn cầu gồm các chuyên gia pháp lý, tuân thủ, an ninh và công nghệ. Tìm hiểu thêm tại ComplexDiscovery.com.
Trí tuệ Nhân tạo Sinh ra và Sử dụng Mô hình Ngôn ngữ Lớn
ComplexDiscovery OÜ công nhận giá trị của các công cụ GAI và LLM trong việc tối ưu hoá quy trình tạo nội dung và nâng cao chất lượng tổng thể của nghiên cứu, viết lách và biên tập. Vì vậy, ComplexDiscovery OÜ thường xuyên sử dụng các công cụ GAI, bao gồm ChatGPT, Claude, Gemini, Grammarly, Midjourney và Perplexity, để hỗ trợ, tăng cường và đẩy nhanh việc phát triển và xuất bản cả nội dung mới và nội dung đã chỉnh sửa trong các bài đăng và trang được xuất bản (bắt đầu từ cuối năm 2022).
Bản dịch tự động bằng AI, thuật ngữ giữ nguyên tiếng Anh.